

Vai al contenuto

Soluzioni di sintesi vocale embedded e on-device

Offri un output vocale coerente, di alta qualità e dal suono naturale su dispositivi smart, elettrodomestici, robotica, chioschi e sistemi IoT. Il sintetizzatore vocale di ReadSpeaker funziona offline, on-device o in deployment ibridi: puoi così integrare voci text-to-speech realistiche ovunque.

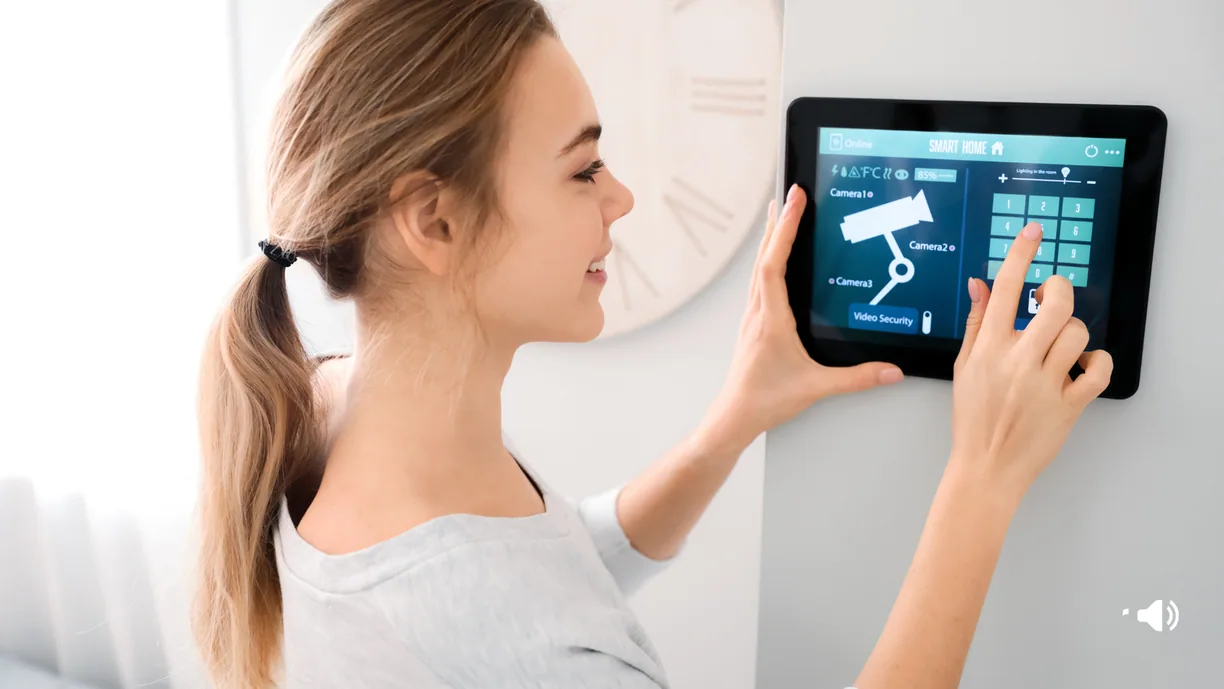
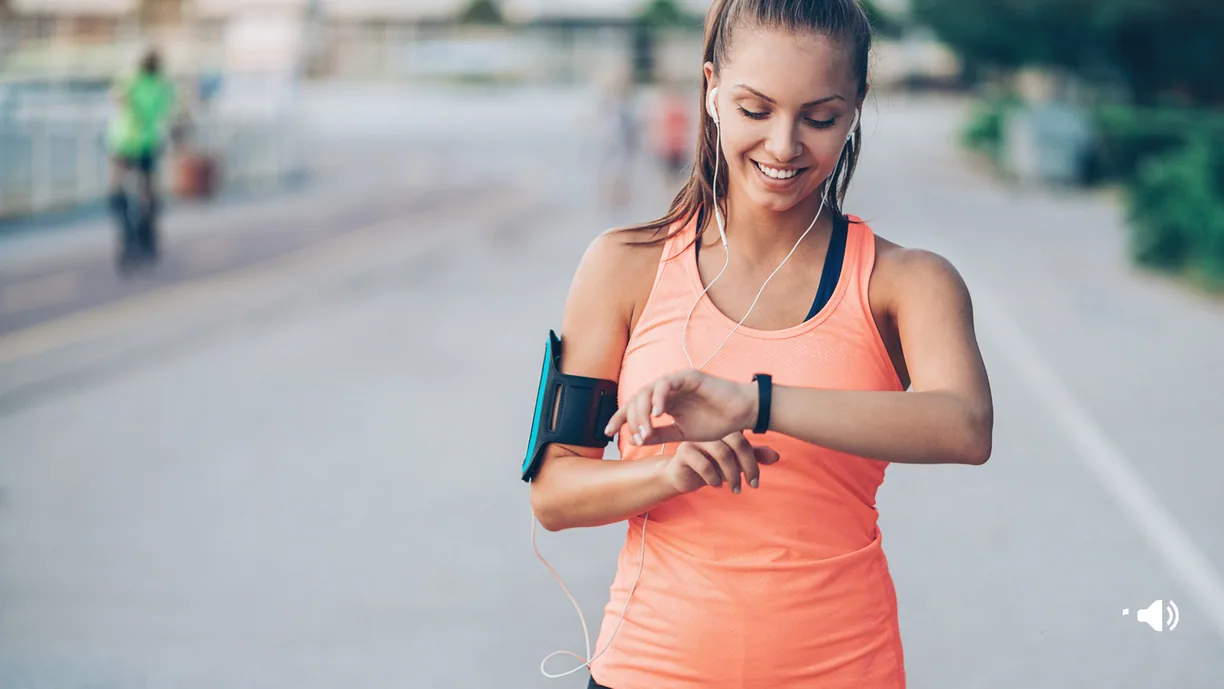
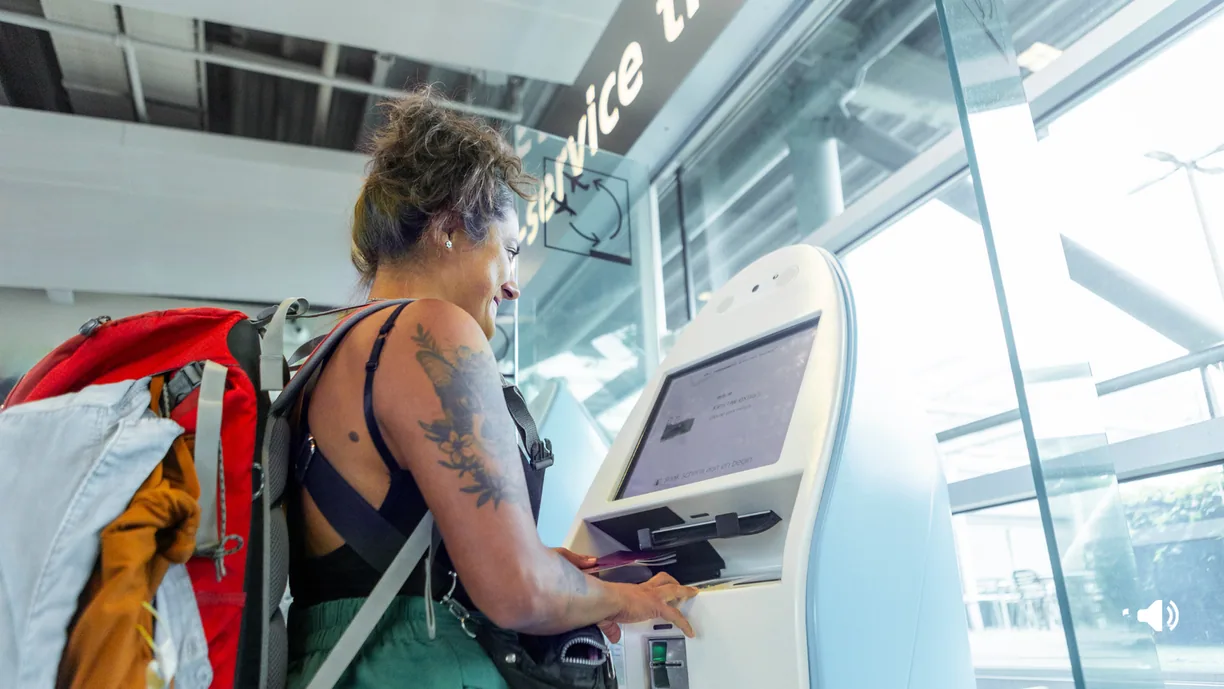
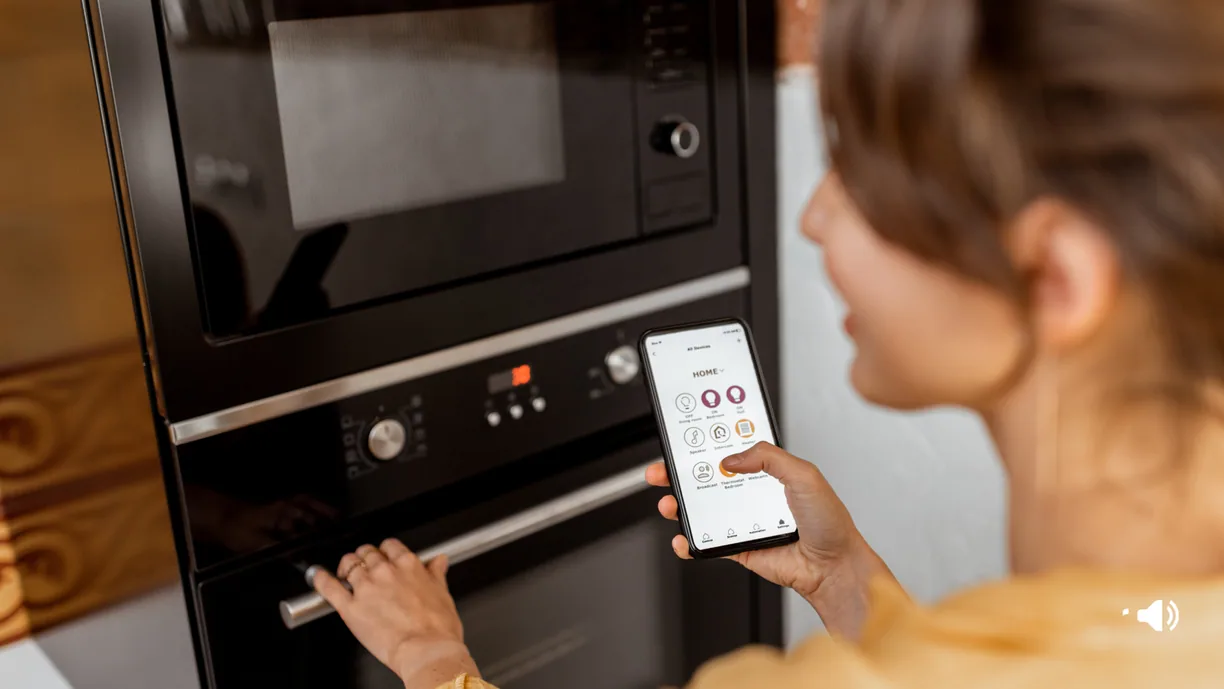
Donna che utilizza un pannello di controllo smart home a parete.Runner che controlla un orologio fitness all'aperto.Viaggiatore con zaino che utilizza un chiosco self-service in aeroporto.Persona che apre un forno a incasso tenendo in mano lo smartphone con un'app.

Porta d'ingresso chiusaObiettivo di passi giornaliero raggiuntoBenvenuto al chiosco self-serviceAvviso di forno pronto

Un pannello di sicurezza domestica conferma che ogni zona è protetta per la notte.

Un dispositivo indossabile si congratula con l'utente per aver raggiunto l'obiettivo di passi della giornata.

Un terminale invita il viaggiatore a toccare lo schermo o a pronunciare una destinazione.

Un elettrodomestico connesso annuncia che il cibo è pronto, e caldo.

Front door locked. All zones are secured. Have a safe evening.

Nice one, you've hit your daily step goal. Keep it up mate.

Welcome. Touch the screen to begin or say your destination to get started.

Your pizza is ready. Please remove it carefully. It's hot.

Scelto da oltre 12.000 organizzazioni nel mondo

Showing logos, group 1 of 4

Casi d'uso

Integra la sintesi vocale in qualsiasi sistema embedded

  1. On-Device/Appliance Voice Feedback, embedded use case

    Feedback vocale on-device e per elettrodomestici

    Permetti ai tuoi dispositivi di parlare in tempo reale senza connessione a internet. Il generatore vocale embedded di ReadSpeaker produce sintesi vocale di alta qualità direttamente sul dispositivo, per un'interazione immediata e privata.

    • Forni, microonde e lavatrici
    • Dispositivi indossabili e tracker per la salute
    • Pannelli di sicurezza smart e sistemi di accesso
    • Dispositivi di tecnologia assistiva
  2. Smart Homes & Domotics, embedded use case

    Smart home e domotica

    Aggiungi alle smart home una sintesi vocale reattiva e multilingue per un'interazione vocale fluida. Grazie al sintetizzatore vocale a basso ingombro di ReadSpeaker, elettrodomestici e sistemi di automazione parlano in modo naturale, offline e sicuro.

    • Termostati e sistemi HVAC
    • Controlli per illuminazione ed energia
    • Elettrodomestici da cucina e per la pulizia
    • Hub e controller smart
  3. Robotics & Assistive Tech, embedded use case

    Robotica e tecnologia assistiva

    Robot e dispositivi assistivi richiedono voci realistiche, dal suono umano per comunicare in modo efficace. ReadSpeaker offre una sintesi vocale espressiva e dal suono naturale, ottimizzata per la robotica e l'accessibilità.

    • Robot di servizio nel retail e nell'ospitalità
    • Robot per l'assistenza sanitaria e per gli anziani
    • Robot didattici e giocattoli educativi
    • Robot da compagnia e sociali
  4. Industrial & Enterprise IoT, embedded use case

    IoT industriale ed aziendale

    I dispositivi industriali richiedono un text to speech offline affidabile in ambienti gravosi o ad alta sicurezza. ReadSpeaker garantisce un'integrazione vocale coerente nei sistemi IoT senza dipendere dal cloud.

    • Pannelli di controllo industriali e di fabbrica
    • Servizi pubblici e sistemi energetici
    • Chioschi self-service e ATM
    • Dispositivi di bigliettazione e validazione per i trasporti
  5. Companion Apps & Cloud Support, embedded use case

    App companion e supporto cloud

    Combina runtime embedded e scalabilità del cloud. Gli SDK embedded e l'API text-to-speech di ReadSpeaker garantiscono la stessa voce di brand su dispositivi, app e dashboard.

    • App mobile per elettrodomestici smart
    • Dashboard IoT
    • Deployment ibridi embedded + cloud
    • Voci unificate su dispositivi e app
  6. Accessible & Inclusive UX, embedded use case

    UX accessibile e inclusiva

    Rendi i dispositivi più semplici da usare per tutti aggiungendo menu, notifiche e avvisi vocali che supportano una progettazione UX inclusiva e obiettivi di accessibilità in linea con i principi della Legge Stanca n. 4/2004, dell'EAA e delle WCAG.

    • Menu per utenti ipovedenti
    • Avvisi vocali per il supporto all'alfabetizzazione e cognitivo
    • Distribuzioni di prodotti multilingue
    • Accessibilità abilitata dalla voce nei dispositivi consumer e industriali

Vantaggi

Perché scegliere il TTS embedded di ReadSpeaker

  • Output vocale veramente embedded

    Genera voci di alta qualità direttamente sul dispositivo. Sempre disponibili, private e sicure.

  • Ottimizzato per dispositivi a basso ingombro

    Ottimizzato per iOS, Android ed Embedded Linux. Motore di sintesi vocale a basso ingombro (6–35 MB per voce). Portabile su altri sistemi su richiesta.

  • Libreria vocale multilingue

    Oltre 150 voci di sintesi vocale in più di 50 lingue per alimentare applicazioni embedded multilingue.

  • Opzioni di deployment flessibili

    Integra tramite SDK embedded, cloud privato o modelli ibridi. API pensate per gli sviluppatori e un toolkit completo semplificano l'integrazione.

  • Coerenza del brand su tutti i dispositivi

    Usa una sola voce coerente su elettrodomestici, app e dashboard. Crea una voce di brand customizzata con il nostro VoiceLab.

  • Prestazioni scalabili e affidabili

    Motore di sintesi vocale embedded collaudato per integrazioni vocali su larga scala.

  • UX inclusiva e accessibile

    Soddisfa gli standard di accessibilità migliorando al contempo l'usabilità con contenuti vocali in più lingue.

  • Supporto linguistico e tecnico esperto

    I nostri linguisti e ingegneri offrono tuning, controllo SSML (Speech Synthesis Markup Language) e ottimizzazione della pronuncia.

  • Esperienza comprovata nel settore

    Decenni di innovazione nel text to speech per automotive, elettronica di consumo, IoT e audiolibri. Il fornitore di text to speech embedded scelto in tutto il mondo.

Lingue e voci

Trova la voce perfetta per i tuoi dispositivi

Che tu scelga una delle nostre oltre 150 voci pronte per il deployment o crei una voce AI customizzata con il nostro VoiceLab, le voci di sintesi vocale di alta qualità di ReadSpeaker si integrano perfettamente negli ecosistemi embedded.

Voci customizzate: rendi unico ogni dispositivo

Con una voce di brand customizzata, i tuoi elettrodomestici, robot e sistemi IoT acquistano un suono unico. Costruisci autorità di brand con una voce riconoscibile distribuita su SDK, API e app companion.

  • Voci customizzate esclusive dal VoiceLab di ReadSpeaker
  • Deployment coerente su dispositivi embedded e app
  • Riconoscibilità e coerenza del brand grazie a voci dal suono umano

Compliance

ReadSpeaker supporta l'allineamento agli standard di accessibilità

  • Accessibilità: conformità ad ADA, EAA e WCAG.
  • Protezione dei dati: ReadSpeaker è conforme al GDPR e certificata ISO/IEC 27001:2022.
  • Voci etiche: tutte le registrazioni vocali sono ottenute e concesse in licenza in modo etico.
  • Privacy First: motori offline senza raccolta di dati utente.

Prezzi

Prezzi sostenibili in base alle tue esigenze

Esempi di modelli di prezzo per il TTS embedded, adattabili al tuo quadro tecnico e commerciale:

Richiedi una prova o un confronto sul pricing
  • Licenze per dispositivopricing OEM per elettrodomestici, dispositivi indossabili e robotica.

  • Abbonamenti cloudpricing basato sull'utilizzo per app e dashboard.

  • Pacchetti di voci customizzatevoci di brand uniche su misura per le tue linee di prodotto.

  • Sconti OEM & enterpriseconvenienza economica su larga scala.

FAQ

Le tue domande, le nostre risposte

Trova risposte rapide alle domande frequenti sui nostri prodotti e servizi di sintesi vocale.

Parla con il nostro team
  • Sì. I nostri motori di sintesi vocale embedded generano localmente una voce di alta qualità e dal suono naturale, ideale per elettrodomestici, robotica e IoT.

  • Il nostro motore di sintesi vocale a basso ingombro funziona su iOS, Android ed Embedded Linux, con un ingombro di circa 6–35 MB per voce. Altri sistemi operativi possono essere supportati su richiesta.

  • Sì. La stessa voce può essere eseguita tramite SDK, nel cloud tramite API text-to-speech o in deployment ibridi.

  • Sì. La nostra libreria di voci multilingue comprende oltre 150 voci in più di 50 lingue, tra cui francese, italiano, coreano e norvegese.

  • Assolutamente sì. Il nostro VoiceLab realizza voci AI customizzate distribuibili su SDK embedded, API e app.

  • La nostra sintesi vocale runtime offline garantisce che i dati restino sul dispositivo. ReadSpeaker opera nel quadro del GDPR ed è conforme allo standard ISO/IEC 27001:2022.

  • Smart home e domotica, robotica e tecnologia assistiva, IoT industriale ed enterprise, elettronica di consumo, gaming e audiolibri.

  • I dispositivi leggono ad alta voce menu, timer e notifiche, garantendo la conformità alla Legge Stanca n. 4/2004, all'EAA e alle WCAG e supportando gli utenti con disabilità visive e difficoltà di alfabetizzazione.

  • No. L'SDK speechEngine offre API avanzate, supporto SSML (Speech Synthesis Markup Language) e documentazione completa.

  • A differenza dei fornitori esclusivamente cloud, ReadSpeaker offre una vera sintesi vocale runtime embedded con prestazioni a basso ingombro, copertura multilingue, voci di alta qualità e supporto agli standard, incluso SSML.

Find your ReadSpeaker solution

Opening the conversation…

Search

    Searching…

    No results for

    Try another wording, or start from one of these.

    Search is not available right now.

    You can still reach the pages below.